Background
同学参加了一个项目,大致是动物个体特征识别, 兽脸识别,其中有一个步骤是对动物个体的拍摄方位做分类,比如正面、侧面、背面等
一看发现有上千张图片,人工分类不太现实,最多人工先分类几十张,然后训练一下模型来辅助,再人工核实。而对于这类目标明确、任务简单的分类场景,直接用支持多模态的大语言模型进行零样本分类就好了
可以先组织一下目录格式,将现有的图片移动到未分类目录里,其他的类别单独新建一个文件夹,并且新建一个不确定的同级类别,防止模型不确定时乱分类
1 | . |
再写一个脚本遍历图片,根据它的输出来移动文件
但是啊,那天下班的时候突然想到豆包有个云电脑来着,而且它本身也是C端里面多模态做的较好的几个,直接让它云端访问数据集执行分类不就行了吗
Use
数据集使用WebDAV协议访问,为了不让它反复直接通过HTTP请求操作文件,可以使用rclone将其挂载到本地,简化为普通文件操作。我这里由于担心豆包犯蠢,只让它将数据集下载到本地,在本地进行分类以后再同步回去。
先安装rclone,豆包也挺聪明的,发现下载速度太慢,还懂得换镜像源下载。
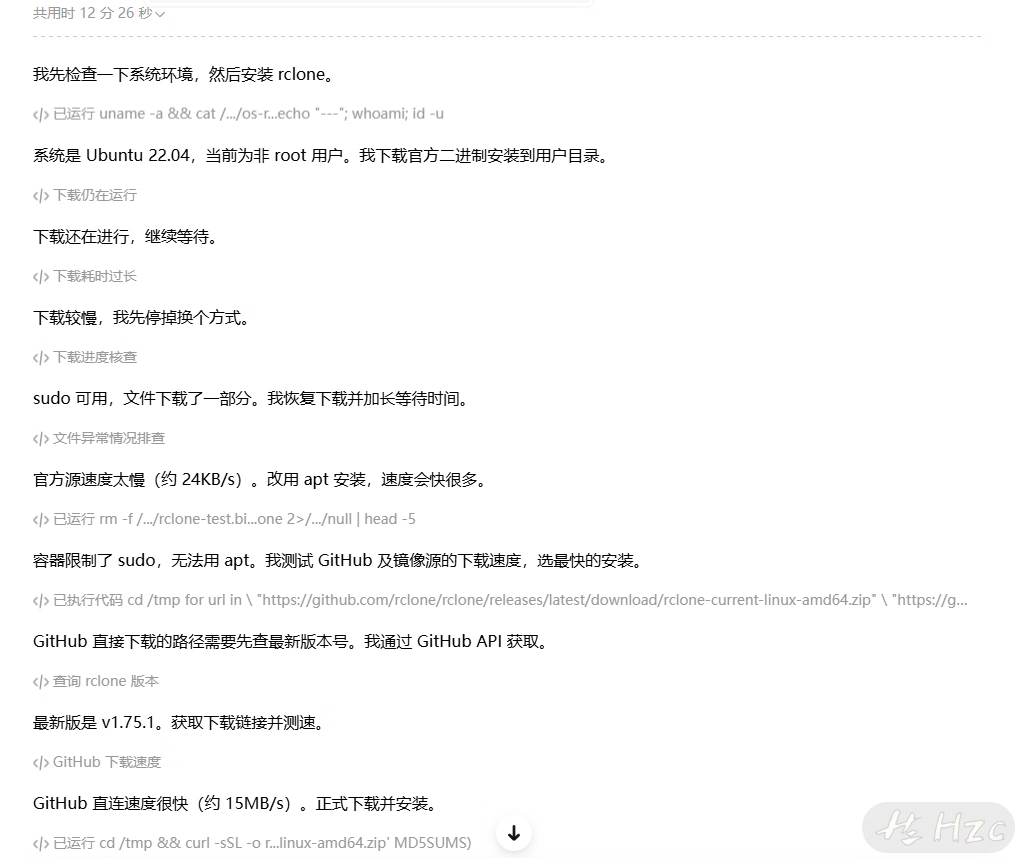
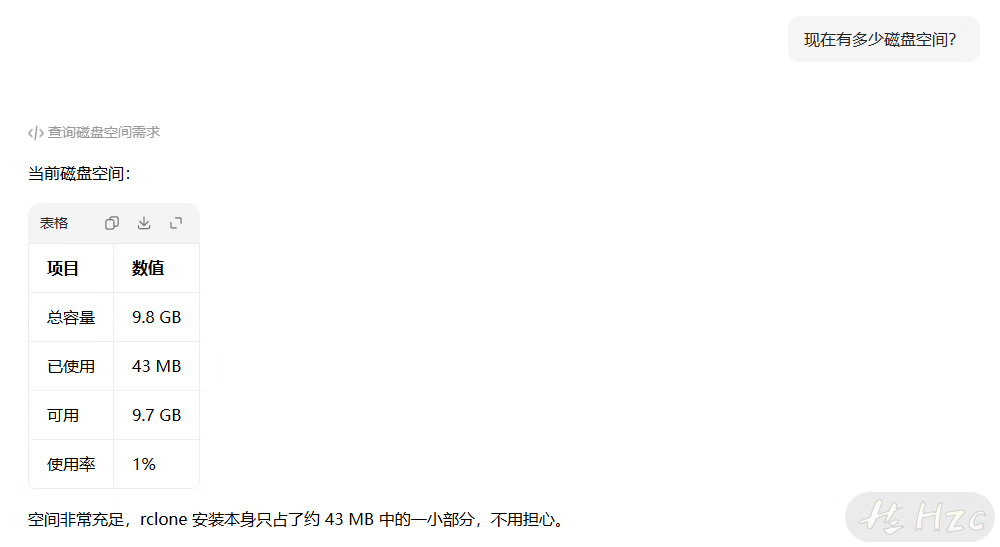
安装好以后还剩近 10G 的空间。
随后创建挂载点,在本地配置好后,直接提供配置文件给它,并让它执行挂载。
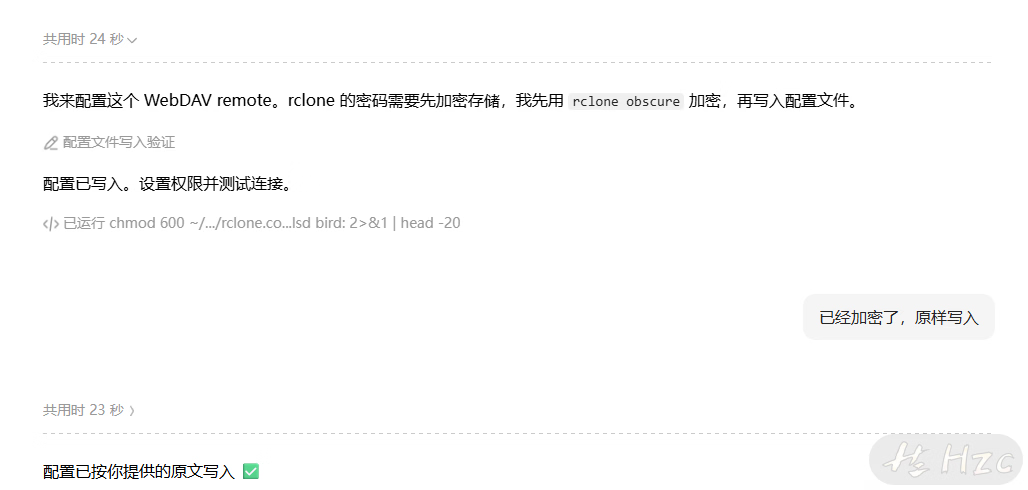
然后发现出现了502错误。本地检查连接是正常的。
用curl -v检查,发现它连接到了一个代理上面,并且是由代理返回的错误。而绕过代理的情况下可以正常访问,估计是触发SSRF防护了
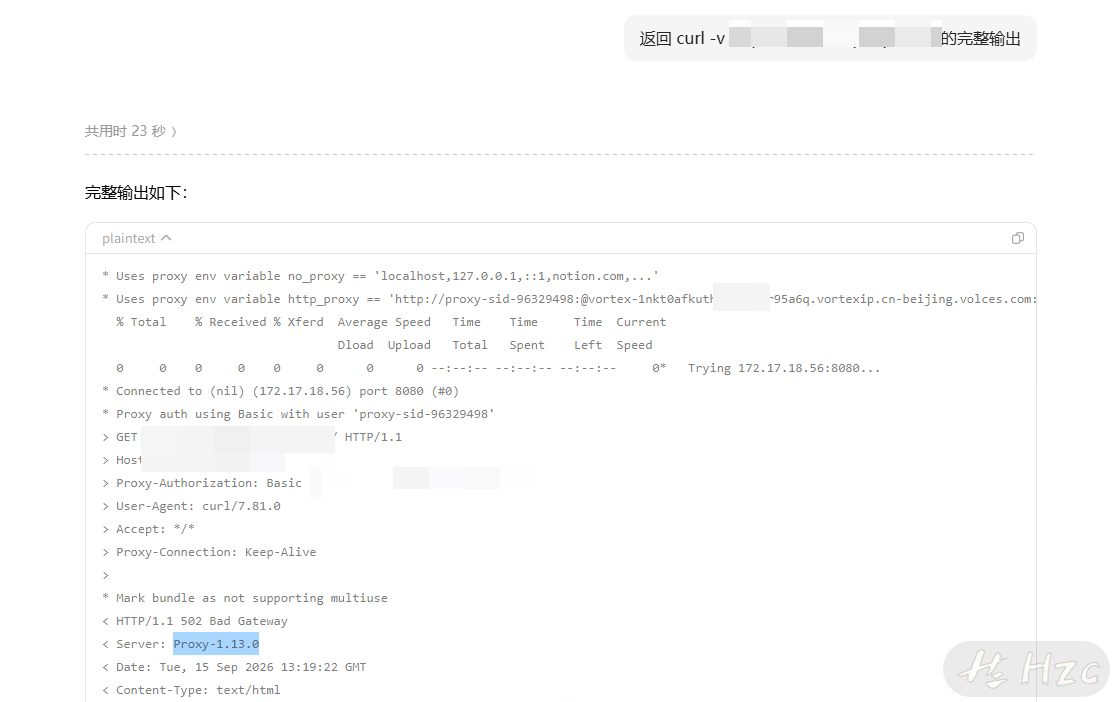
取消系统代理后就可以正常列出文件目录了。随后告诉它待分类数据集的路径和要求,就会自动分类
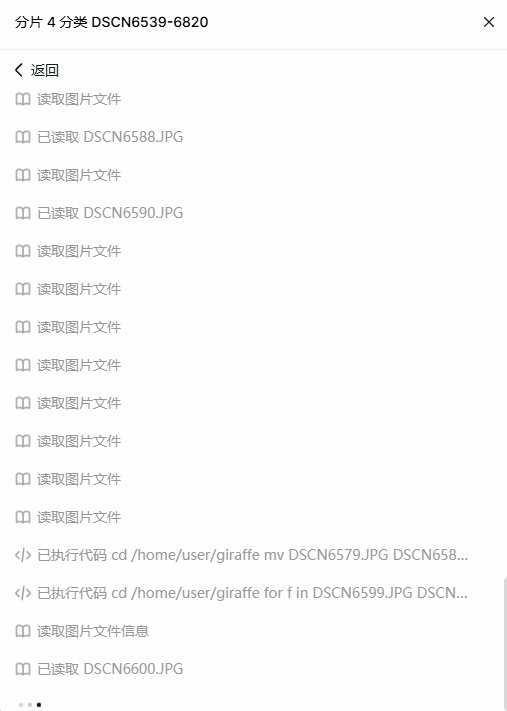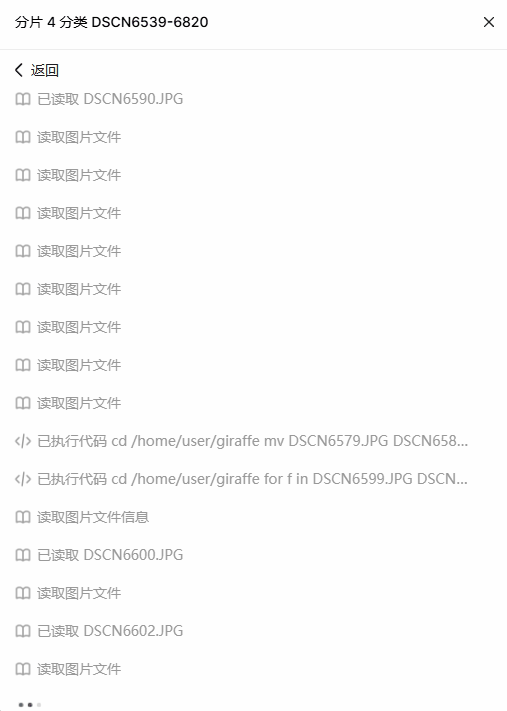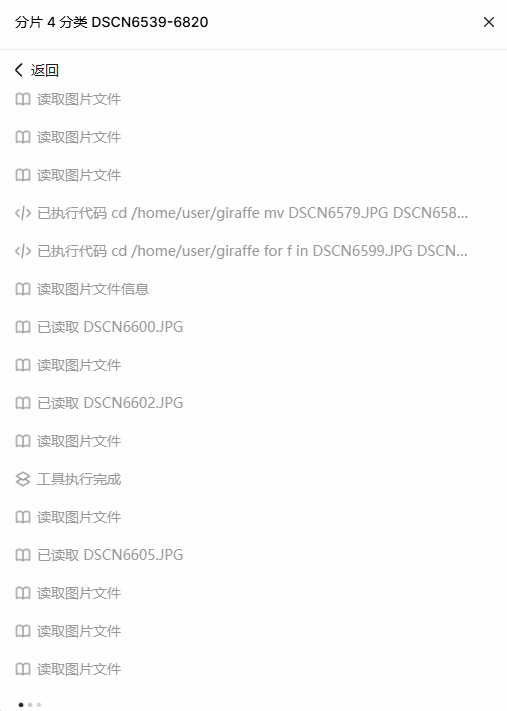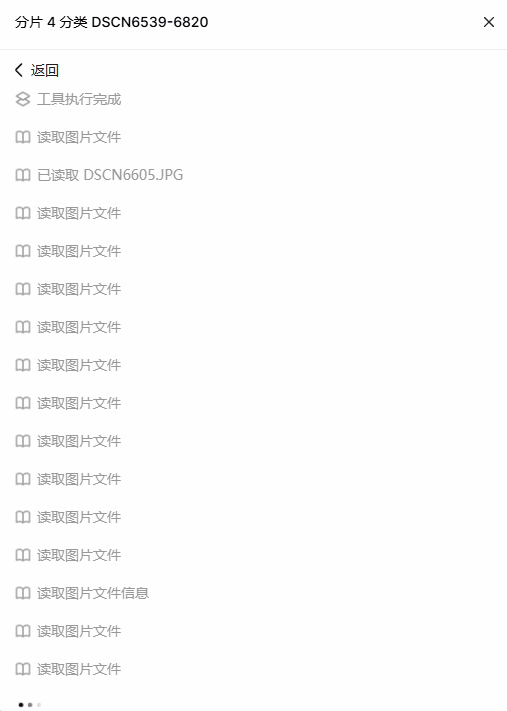
最后就是同步分类结果。其实应该让它再写个脚本,根据现有目录结构依次执行move操作,直接用sync的话会额外全量同步一次数据。但是吧,管它呢,流量又不要钱
End
来几张图片,期待这个项目落地那一天,游客们能在动物园里给动物拍一张图片就能认出来动物叫什么名字吧